

点击上方蓝字关注我们

-
机器学习基本概念和机器学习分类 -
机器学习在培养基优化中的应用研究进展 -
基于机器学习的培养基优化的基本步骤 -
机器学习应用案例1 -
机器学习应用案例2 -
…….
01
基于机器学习的培养基优化的基本流程
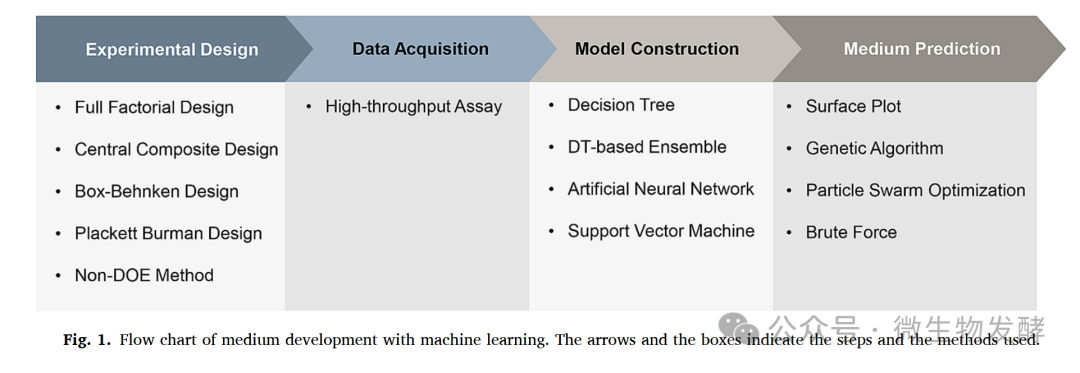
02
Experimental design实验设计
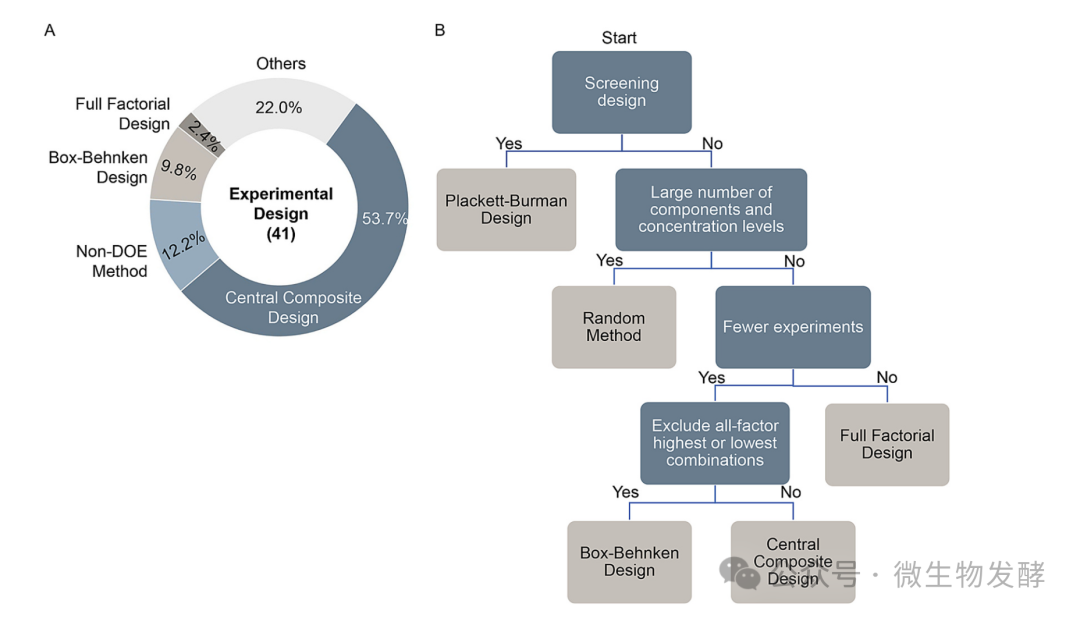
第一步是确定我们的培养基优化的目标,并采取合理的方法获取训练数据。在这个过程中,我们是希望找到对我们的优化目标有显著影响的因子,并获得一系列因子的水平对目标值的影响样本。design of experiments (DOE)方法是建议选取的方法:Full Factorial Design(全因子设计),Central Composite Design(中心复合设计),Box-Behnken Design(Box-Behnken设计),Plackett Burman Design(Plackett Burman设计)。由上图可以看出,CCD方法是培养基优化训练数据的主要来源。不过我们需要注意的是,CCD的实验因子需要用到PB实验,单因素实验等实验的筛选。详细的介绍可以看以下内容,不再做赘述。
03
Data acquisition 数据获取
3.1 数据格式规范
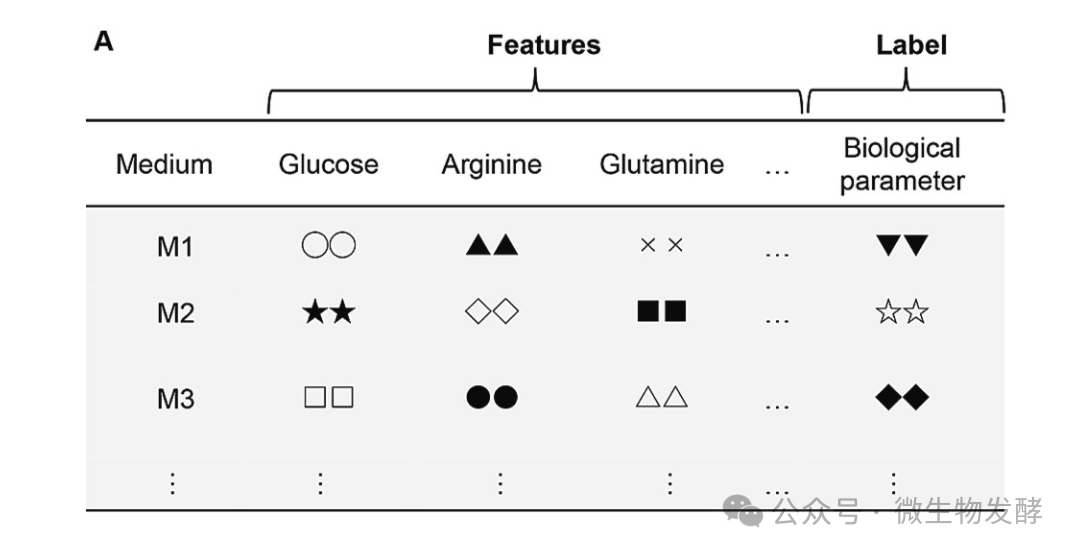
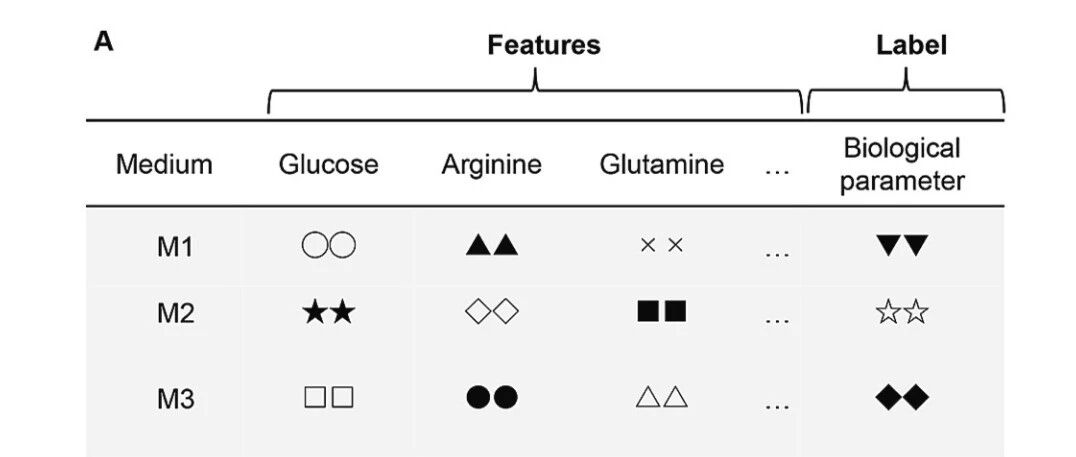
数据整理格式如上图,M1-Mi是不同的实验组,或样本(sample)或示例(instance);葡萄糖(Glucose)浓度等是输入参数,也是特征值(Features),biological paramete比如生物量,酶活性是标签或者说是目标参数。需要注意的是在培养基优化中,标签一般是数值而不是类别。
一般我们需要将数据集划分为以下三部分:
训练集(Training Set)
- 作用:用于模型训练,学习数据中的规律。
- 占比:通常占数据总量的60%-80%。
验证集(Validation Set)
- 作用:调参(如学习率、网络层数)和选择最佳模型,防止过拟合。
- 占比:10%-20%。
- 测试集(Test Set)
- 作用:最终评估模型泛化性能,模拟真实场景。
- 占比:10%-20%。
- 关键规则:测试集仅在模型训练完成后使用一次,不可参与任何参数调整。
3.2 数据预处理
原始数据需要经过以下步骤进行预处理:原始数据 → 清洗 → 归一化 → 分割为训练/验证/测试集。
(1)当数据量少是我们一般手动进行数据清洗
| 问题类型 | 清洗方法 | 示例 |
|---|---|---|
| 缺失值 |
|
age 列的缺失值用该列中位数替代 |
| 异常值 |
|
temperature 列中 >50℃ 的异常记录 |
| 重复数据 |
|
|
| 格式错误 |
|
"¥100" 转换为浮点数 100.0 |
| 单位不统一 |
|
5km 和 3000米 统一为 5000米 |
(2)当输入参数的单位存在较大差异时,需要对数据进行标准化和归一化处理,当然是否需要归一化处理,可根据结果的好坏进行判断。
04
Model construction 建模
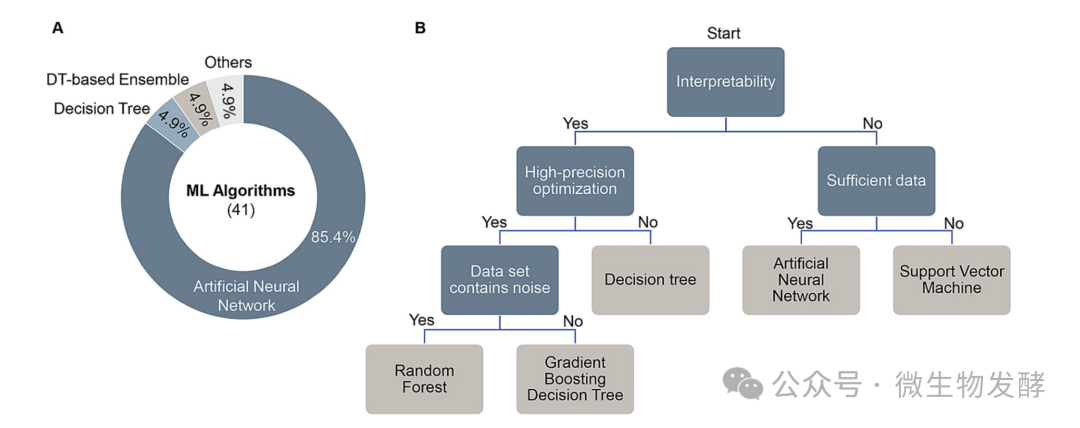
建模是机器学习的核心,建模的本质就是“从数据中总结规律,再让这个规律能解决新问题”。这其中的规律是一种黑箱性质或者有一定可解释性的的公式或者是规律。在机器学习进行培养基优化时,方法选择可依据可解释性、数据量和数据集是否含噪声来决定。若需高可解释性,数据充足选决策树,其能清晰展示特征对结果的影响;数据不足则选支持向量机,它适合处理小样本数据。若无需高可解释性,数据集含噪声选随机森林,其对噪声鲁棒性好;数据集不含噪声则可选用梯度提升决策树或人工神经网络,前者迭代优化准确性高,后者能处理复杂关系。
机器学习的种类在以下内容有做介绍,不再做赘述:
从OFAT与RSM到机器学习:解锁培养基优化密码系列-机器学习基本概念和机器学习分类
由上图可以看出,在培养基优化中,现在应用最多的就是神经网络方法,其他方法应用较少。
05
预测和验证
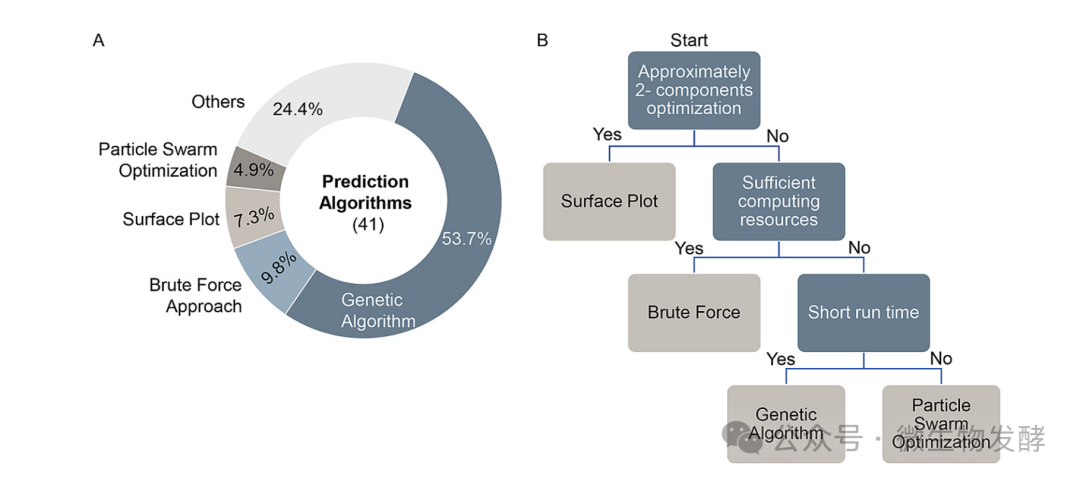
构建的机器学习模型可预测新型培养基成分以优化细胞培养效果,但其预测需以现有培养基成分数据为基础。由于潜在的培养基组合近乎无限,因此需在计算资源和时间限制下设计实用的搜索策略。
在机器学习进行培养基优化选择预测方法时,首先判断是否近似2组件优化,若是则选择Surface Plot(曲面图法);若不是则进行计算资源判断。若有足够计算资源,当运行时间较短时选择暴力破解法(Brute Force),其可有效探索解空间,若运行时间长则选择粒子群优化算法(Particle Swarm Optimization),它能在复杂解空间中有效搜索最优解。若计算资源不足,运行时间短可选择遗传算法(Genetic Algorithm),利用其启发式搜索能力找较优解,运行时间长仍选择粒子群优化算法。此外,参考图A统计数据,遗传算法在预测算法中占比最高达53.7%,是常用且有效的选择,暴力破解法占9.8%,粒子群优化算法占4.9%,曲面图法占7.3%,其他方法占24.4%,在无明确条件指向其他方法时可优先考虑遗传算法,通过这样的决策流程和参考统计数据,能在不同条件和需求下合理选择预测方法以达较好效果和效率。
参考文献:Challenges in developing cell culture media using machine learning

推荐阅读
Recommended reading

微生物发酵培训和会议:
【上海·4月18日-20日】2025第四届发酵产业高峰论坛暨菌种构建及智能生物制造技术创新与应用研讨会
发酵工程进阶课·从基因到产物,深度学习×多组学理性解析微生物发酵过程,驱动过程优化和控制
往期文章